La utilización de modelos de lenguaje de gran tamaño (LLMs) como clasificadores ha generado grandes expectativas dentro del ámbito del procesamiento de datos y la inteligencia artificial. Sin embargo, la implementación práctica de estas herramientas en tareas de clasificación presenta desafíos significativos, a pesar de su rendimiento aceptable en ciertas pruebas. Comprender los conceptos clave y cómo optimizar el uso de LLMs es esencial para cualquier emprendedor y profesional en el sector tecnológico.
Desafíos de los LLMs como clasificadores
Uno de los principales problemas al trabajar con LLMs como clasificadores es la calibración de sus predicciones. Los resultados suelen ser considerados «hard labels», lo que significa que pueden carecer de una medida clara de la confianza en las predicciones. Aunque ofrecen probabilidades token por token, estas no se correlacionan necesariamente con niveles de confianza bien calibrados. Esto dificulta el ajuste adecuado entre precisión y recall.
Además, aunque los LLMs excelen con datos no estructurados, su efectividad con datos estructurados no está garantizada. A pesar de que colaboradores pueden añadir información relevante en los prompts, no siempre queda claro si los LLMs utilizan estos datos de manera efectiva, lo que puede implicar pérdidas relevantes de señal en la clasificación. También surge el problema de la interpretabilidad: aunque se puede entender la estructura del prompt, la lógica interna del modelo y su interpretación de los datos no siempre son transparentes.
Mejorando el rendimiento mediante ingeniería de características
Para optimizar el uso de un LLM como clasificador, la clave puede estar en la ingeniería de características. En lugar de depender únicamente del LLM, se puede integrar su output en modelos más tradicionales, como la regresión logística. Al hacerlo, se logran calibraciones más precisas y permite incorporar múltiples variables que enriquecen el contexto de clasificación. Esto no solo mejora el modelo, sino que también facilita un enfoque más adaptativo al contexto de los datos, aumentando su fiabilidad en diferentes poblaciones de interés.
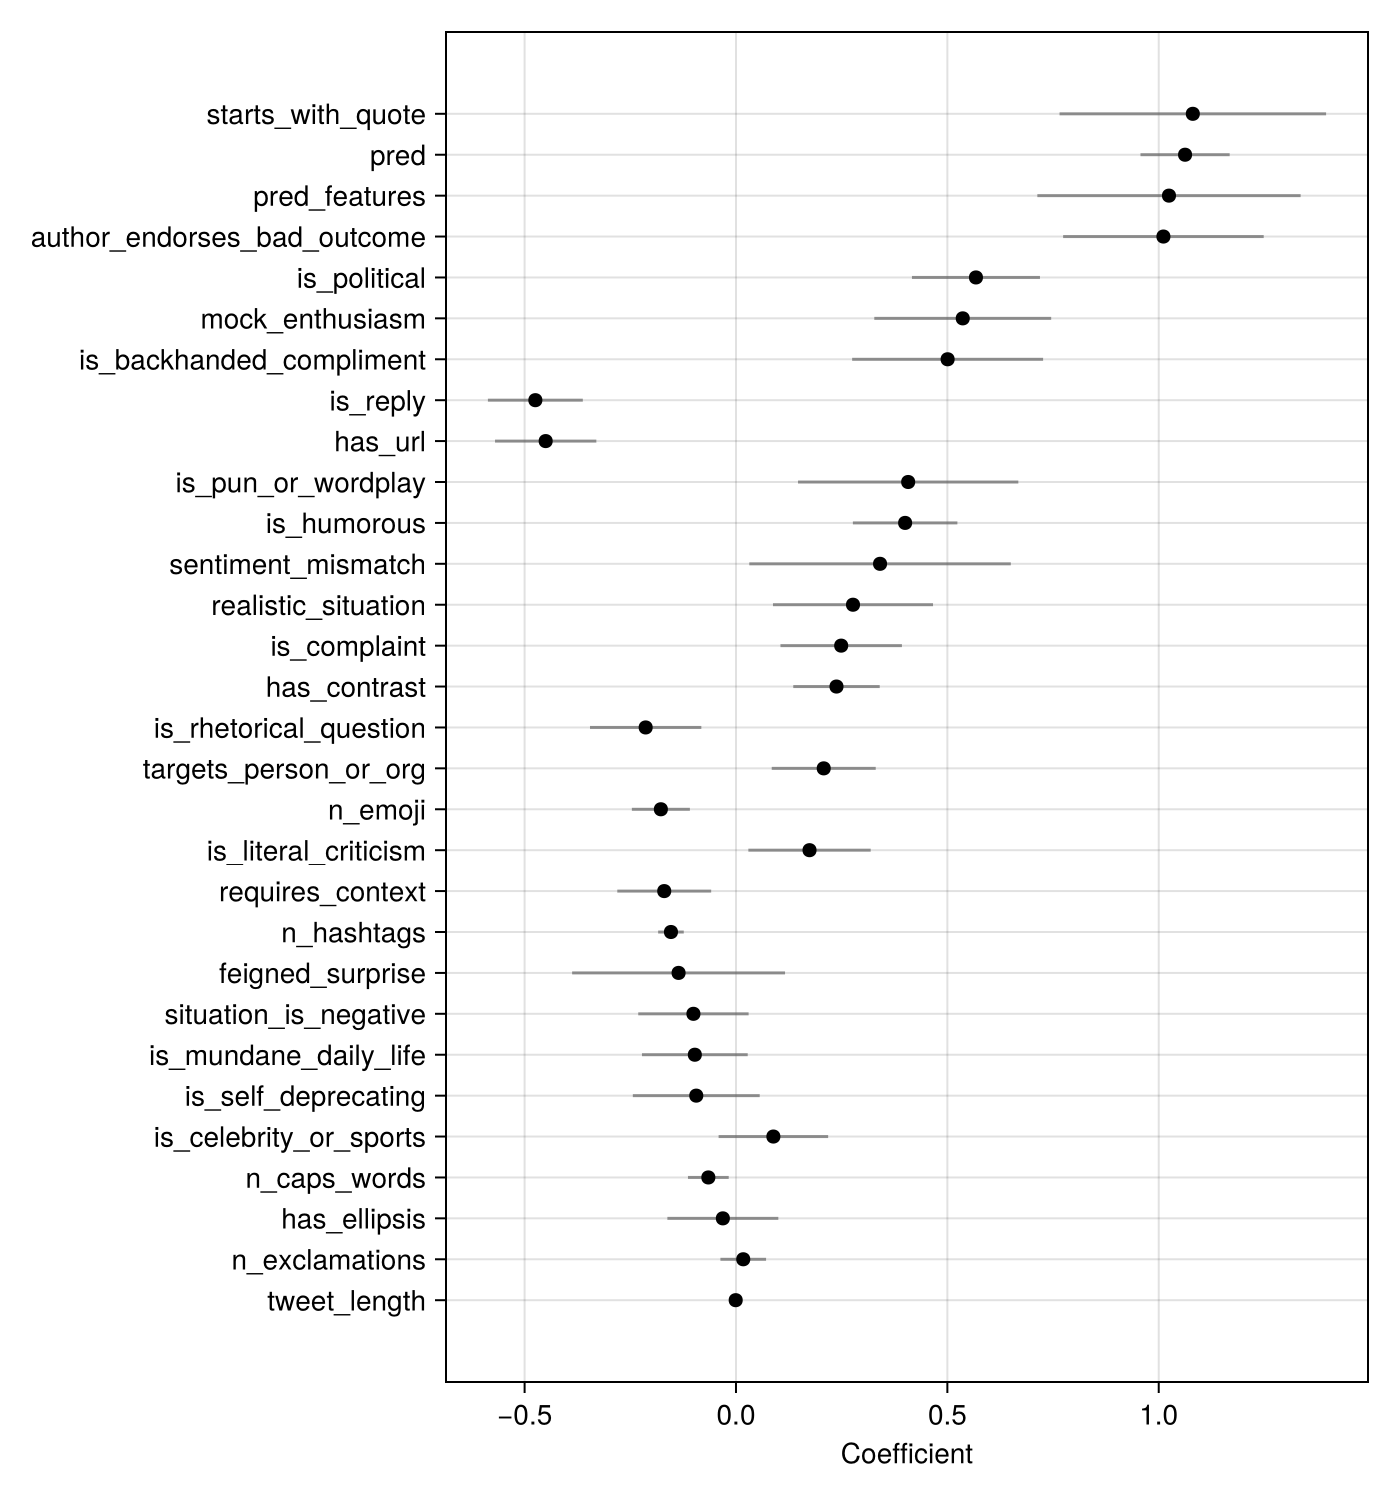
Al agregar más características, la adaptabilidad del modelo se potencia. Esto puede incluir desde datos de entrenamiento adicionales hasta características basadas en el análisis del comportamiento en redes sociales, como el uso de emojis o el número de hashtags. Cuanta mayor diversidad y profundidad de información se integre, más robusto será el desempeño del modelo resultante.
Un caso práctico: detección de ironía
Un ejemplo revelador de la utilidad de esta metodología se encuentra en la detección de ironía en tuits. Un estudio aplicado utilizando un conjunto de datos de SemEval para evaluar la ironía mostró un desempeño notable al utilizar LLMs en combinación con características adicionales. Inicialmente, un modelo simple basado en las respuestas de un LLM alcanzó un F1 de 0.747. Al incorporar características determinísticas, como la longitud del tuit y la presencia de URLs, se logró aumentar el rendimiento, alcanzando un F1 de 0.779.
Los resultados destacan la importancia de integrar diversos modelos y características para mejorar la precisión de los LLMs en tareas específicas, además de mostrar cómo la interpretación de factores puede iluminar cuáles son las características más influyentes para el modelo.
Conclusiones y futuro de los LLMs en clasificación
En conclusión, aunque los LLMs presentan limitaciones significativas como clasificadores, su potencial puede maximizarse mediante un enfoque estratégico que incluye ingeniería de características y la combinación con modelos más tradicionales. Esto no solo optimiza el rendimiento en clasificación, sino que también aporta un marco interpretativo robusto.
A medida que más investigaciones y aplicaciones continúan explorando el uso de LLMs en clasificación, se abre una puerta a oportunidades frescas para emprendedores y empresas que buscan aprovechar la inteligencia artificial de manera efectiva y responsable. La curiosidad y el deseo de explorar nuevos modelos de clasificación serán fundamentales en este panorama futuro, donde la innovación desempeñará un papel crucial.