Innovaciones en la Computación Local: NVIDIA y el Modelo GLM-5.3
La inteligencia artificial avanza a pasos agigantados, y la capacidad de ejecutar modelos complejos localmente está en el centro de este progreso. Uno de los recientes desarrollos en este ámbito es el modelo GLM-5.3 de NVIDIA, el cual cuenta con la asombrosa cifra de 753 mil millones de parámetros. Este modelo utiliza la arquitectura de mezcla de expertos (MoE) y ha sido optimizado para funcionar en equipos de alto rendimiento.
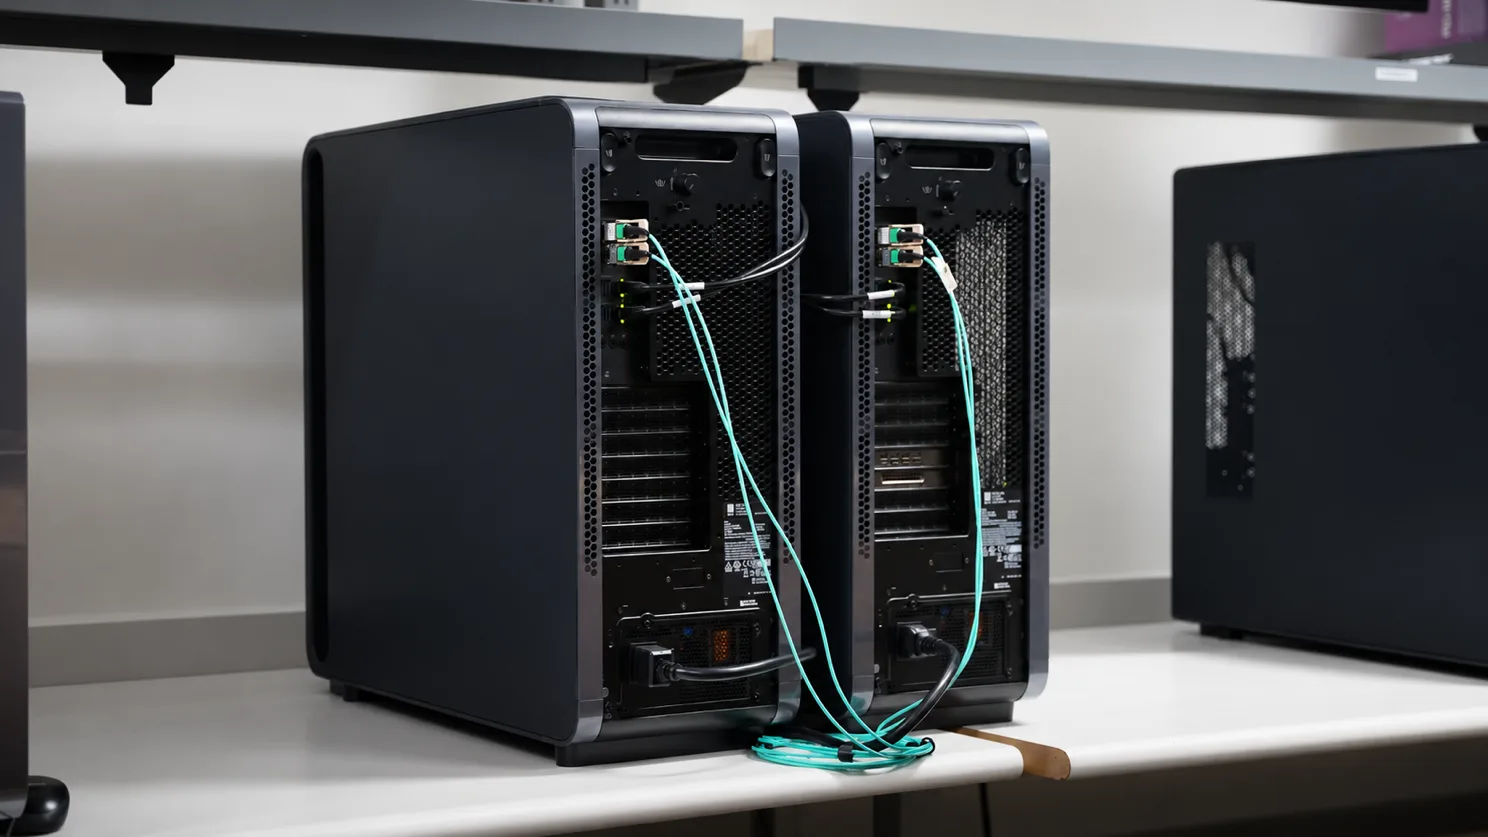
El GLM-5.3, diseñado para ser ejecutado en dos estaciones NVIDIA DGX simplifica la carga de trabajo mediante el uso de paralelismo tensorial. Este sistema permite repartir los pesos del modelo entre dos GPUs, maximizando la capacidad de memoria, ya que los modelos de gran escala han dejado de caber en una sola máquina.
Las Estaciones NVIDIA DGX y su Conectividad
Para ejecutar el modelo GLM-5.3 de manera local, es necesario contar con dos estaciones NVIDIA DGX conectadas a través de la tecnología ConnectX-8 RDMA. Esto no solo facilita el acceso a la memoria del modelo, sino que también garantiza que cada token sea procesado de manera eficiente, utilizando la activación dispersa y permitiendo que hasta 40 mil millones de parámetros se activen por token, reduciendo así las necesidades computacionales.
El checkpoint del modelo, que supera los 464 GB, demuestra que la infraestructura de NVIDIA ha sido diseñada para soportar la magnitud de operaciones requeridas por modelos de esta naturaleza. La combinación de dos DGX Stations permite mantener todos los pesos del modelo en la memoria de las GPUs, optimizando en gran medida la capacidad de respuesta y rendimiento del modelo.
Requisitos para la Implementación
El proceso para implementar el modelo incluye varios requisitos específicos. Se necesitan dos DGX Stations que corran Linux, cada una con acceso a la misma cuenta de usuario y permisos de SSH. Adicionalmente, es crucial contar con un espacio de disco libre considerable, un entorno de Docker configurado, y contar con permisos adecuados para acceder a registros de contenedores y paquetes de modelos.
El procedimiento también implica crear un archivo de entorno que contenga variables esenciales y ejecutar comandos de prueba para asegurarse de que ambas estaciones estén correctamente conectadas. Esta preparación es clave para evitar errores de conexión y asegurar una correcta sincronización entre los sistemas.
Ejecutando el Modelo GLM-5.3
Una vez configuradas las estaciones y realizado el proceso de carga de pesos del modelo, se procede a lanzar un servicio distribuido que fomenta la cooperación entre ambas unidades de procesamiento. Cada estación se encarga de una parte del modelo, lo que permite realizar operaciones de inferencia de manera conjunta.
La ejecución del modelo se realiza mediante un script que arranca el servicio en ambas estaciones, configurando parámetros cruciales como la longitud máxima del modelo y el almacenamiento en caché de tokens. Este enfoque permite gestionar peticiones concurrentes, lo que convierte al sistema en una potente herramienta para la inferencia de datos en tiempo real.
Medición de Rendimiento y Resultados
Para evaluar el rendimiento del sistema, se utiliza AIPerf, una herramienta de evaluación que mide la latencia y el rendimiento de las peticiones. Este tipo de pruebas ofrece información detallada sobre cómo se comporta el modelo bajo diferentes cargas de trabajo y configuraciones de concurrencia. Los resultados indican un rendimiento óptimo, alcanzando picos de hasta 607.8 tokens por segundo en pruebas con alta concurrencia.
Estos avances no solo demuestran la capacidad técnica de manejar modelos gigantescos localmente, sino que también abren un abanico de posibilidades para empresas que buscan realizar inferencias sobre datos sensibles sin depender de servicios en la nube.
La implementación del modelo GLM-5.3 en estaciones NVIDIA DGX así como su capacidad de ejecución local, establece un nuevo estándar en el campo del aprendizaje automático y la inteligencia artificial, permitiendo que más organizaciones accedan a herramientas potentes para su análisis de datos y desarrollo tecnológico.