La evaluación de modelos de inteligencia artificial se ha convertido en un tema candente en el sector tecnológico, con laboratorios de IA apostando su reputación en sistemas de benchmarking que prometen medir la efectividad de uno frente a otro. Sin embargo, los métodos utilizados en estas evaluaciones son complejos y aún están en desarrollo, lo que plantea serias dudas sobre su confianza y utilidad a largo plazo.
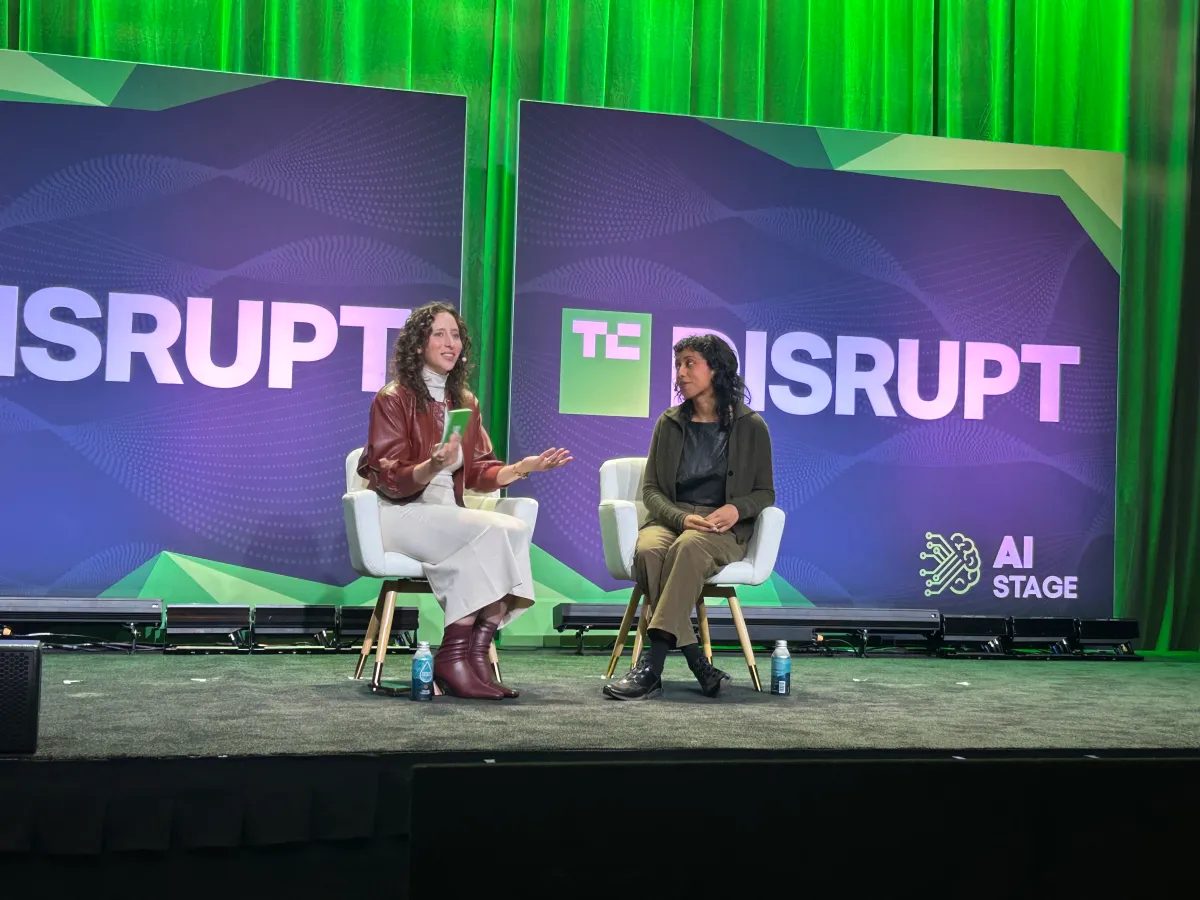
Durante un reciente panel de discusión, Irene Solaiman, directora de políticas de Hugging Face, subrayó la necesidad de que los métodos de prueba en la industria evolucionen hacia una ciencia más consistente. La capacidad de reproducir los resultados es fundamental para establecer la validez de cualquier evaluación, y esto se relaciona estrechamente con la accesibilidad a los modelos evaluados, un aspecto donde los pesos abiertos juegan un papel crucial.
La reproducibilidad se ha mantenido como uno de los aspectos más desafiantes en el benchmarking de modelos, generando debates significativos en el sector. Además, surge la cuestión de la comparación entre diferentes tipos de evaluaciones, lo que también resulta un área en evolución en el campo de la inteligencia artificial.
La necesidad de estandarización en la evaluación de modelos
Solaiman mencionó que las pruebas comienzan a perder su eficacia con rapidez y que aún no existe un ecosistema robusto necesario para una evaluación efectiva. Existe un gran interés por un sistema de evaluadores embebidos, en el que observadores supuestamente «neutrales» se integren en las organizaciones de IA. Esta idea ha cobrado relevancia tras varios incidentes de seguridad que han despertado temores acerca de los riesgos de estas tecnologías.
Frente a la falta de regulación gubernamental, los laboratorios han optado por esta solución de evaluación externa. No obstante, la eficacia y neutralidad de estos evaluadores ha sido cuestionada, como evidenció la decisión de Anthropic de contratar a Accenture, que recibió críticas sobre su capacidad para desempeñar esta función.
Los enfoques de evaluación han evolucionado, trasladando el enfoque de la mera prueba del modelo a una evaluación del sistema completo que lo rodea. Esto incluye no solo al modelo en sí, sino también al «harness» o herramienta que los usuarios utilizan para acceder al modelo. Solaiman destacó que un modelo menos potente pero con un mejor harness podría superar fácilmente a uno de primera línea. Por otro lado, evaluar la interacción de un «agente» y su entorno ha resultado ser un proceso costoso y complicado.
En resumen, la evaluación en el ámbito de la inteligencia artificial se encuentra en un punto crítico. La falta de un enfoque uniforme podría limitar la efectividad del benchmarking como herramienta para los líderes de la industria. Se requiere un consenso en los métodos y estándares para garantizar que todos los actores del sector operen bajo condiciones equitativas y confiables.