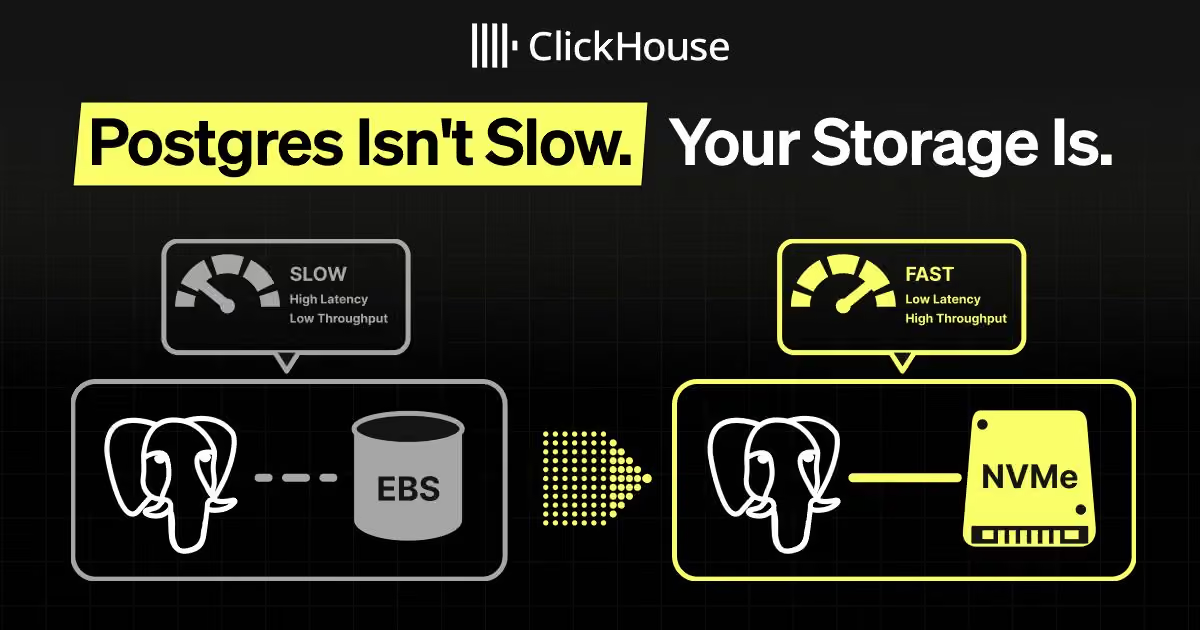
La presentación de Sai Srirampur en el evento POSETTE 2026, titulada «Postgres No Es Lento. Tu Almacenamiento Sí», abordó un tema crucial para quienes manejan PostgreSQL a gran escala: la influencia del rendimiento de almacenamiento en las operaciones de bases de datos. Con un análisis exhaustivo, Srirampur desglosó cómo las deficiencias en el almacenamiento pueden provocar problemas de rendimiento que afectan la eficiencia de las operaciones, a menudo sin ser detectadas por el equipo técnico.
Uno de los principales enfoques de la charla fue identificar las cinco manifestaciones comunes que surgen cuando un entorno de PostgreSQL alcanza volúmenes significativos de datos, con cargas de trabajo concurrentes y altas tasas de procesamiento. Estas son:
- Ingesta lenta: A medida que la cantidad de datos aumenta, las tareas de actualización pueden requerir mucho más tiempo del habitual.
- Latencia de lectura inconsistente: Mientras que algunas consultas se mantienen rápidas, otras pueden empezar a experimentar demoras significativas.
- VACUUM rezagado: Un crecimiento en la actividad de actualizaciones conlleva una acumulación de bloat en las tablas.
- Puntos de control más lentos: Estos pueden interrumpir las cargas de trabajo al competir por recursos de I/O.
- Retraso en la replicación lógica: Este síntoma se manifiesta al transmitir datos a sistemas externos, creando cuellos de botella en la decodificación de WAL.
Los problemas mencionados no siempre tienen un origen común, pero a menudo tienen un denominador: el rendimiento del almacenamiento. Este es el hilo conductor que conecta síntomas aparentemente no relacionados dentro de un sistema de PostgreSQL.
El impacto del almacenamiento en el rendimiento
Si el conjunto de trabajo de PostgreSQL excede la memoria y el caché del sistema operativo, se requerirá más lectura de datos desde I/O físico. Un almacenamiento lento aumenta el costo de dichas lecturas, lo que resulta en mayores latencias promedio y de «tail». La competencia por el ancho de banda y las operaciones por parte de las consultas del cliente y las tareas de mantenimiento puede agravar estos retrasos.
Srirampur llevó a cabo un experimento de comparación entre una carga de trabajo de 3.3 mil millones de filas utilizando almacenamiento EBS estándar y almacenamiento NVMe local. Al utilizar ocho clústeres idénticos de PostgreSQL, se logró aislar las variables involucradas y se realizaron las pruebas bajo condiciones controladas.
Resultados del benchmark: NVMe vs EBS
Los resultados del benchmark fueron contundentes: los clústeres configurados con almacenamiento NVMe lograron una media de 16,030 transacciones por segundo (TPS), mientras que los que usaban EBS alcanzaron solo 1,734 TPS, lo que representa una diferencia de 9.24 veces. Asimismo, la latencia de transacciones se redujo notablemente de 36.9 ms a 4.0 ms.
En operaciones adicionales, el tiempo para completar un VACUUM de 10 GB de bloat fue muy inferior en NVMe (366 segundos) comparado con EBS (964 segundos), subrayando la efectividad de los sistemas locales en un ambiente de alta demanda de datos.
La cuestión de la durabilidad
Sin embargo, el uso de NVMe no está exento de desafíos. Dado que el almacenamiento de instancia se pierde al finalizar la vida útil de una máquina, es crucial plantear un modelo operativo que asegure la durabilidad de los datos. La solución propuesta implica replicar la base de datos para mantener la disponibilidad, realizar copias de seguridad y conservar los datos de recuperación fuera de los nodos individuales.
Arquitectura de producción para PostgreSQL respaldado por NVMe
La arquitectura planteada por Srirampur se basa en tres necesidades clave: implementar una replicación sincronizada que use candidatos de respaldo para asegurar la disponibilidad, mantener copias de seguridad continuas en almacenamiento externo, y planificar la capacidad en función del NVMe disponible en cada tipo de instancia.
Un ejemplo de esta metodología está en el uso de replicación síncrona basada en quórum, que permite confirmar transacciones tan pronto como uno de los dos nodos secundarios reconoce durablemente los registros WAL, facilitando así la recuperación frente a fallos en la zona de disponibilidad.
Además, herramientas de código abierto pueden facilitar la creación de copias de seguridad físicas y archivos WAL almacenados de manera continua, logrando así un objetivo de punto de recuperación (RPO) de segundos, lo que permite una recuperación ante desastres eficaz.
Conclusiones
La presentación concluyó con un consejo diagnóstico: cuando PostgreSQL parece no escalar adecuadamente, es esencial examinar tanto la base de datos como el almacenamiento. La capacidad de una arquitectura bien diseñada, combinando almacenamiento rápido con replicación y copias de seguridad eficaces, puede resolver muchos de los problemas relacionados con la latencia y el rendimiento, asegurando así que los sistemas PostgreSQL se mantengan robustos y efectivos incluso ante cargas de trabajo crecientes.