La arquitectura de redes neuronales conocida como Transformer ha revolucionado el campo de la inteligencia artificial desde su introducción en 2017. Este modelo ha establecido un nuevo estándar que impulsa los avances en aprendizaje profundo y ha dado lugar a aplicaciones innovadoras en diversas áreas, incluyendo la generación de texto, el reconocimiento de imágenes y la predicción de estructuras proteicas.
El principio fundamental que guía a los modelos generativos de texto basados en Transformers es la predicción del siguiente token. Esto significa que, dado un texto proporcionado por el usuario, el modelo evalúa cuál es el token (una palabra o parte de una palabra) más probable que sigue. La grandeza de esta arquitectura radica en su mecanismo de autoatención, que permite procesar secuencias completas y captar dependencias a largo plazo de manera más eficiente que arquitecturas anteriores.
Componentes clave del Transformer
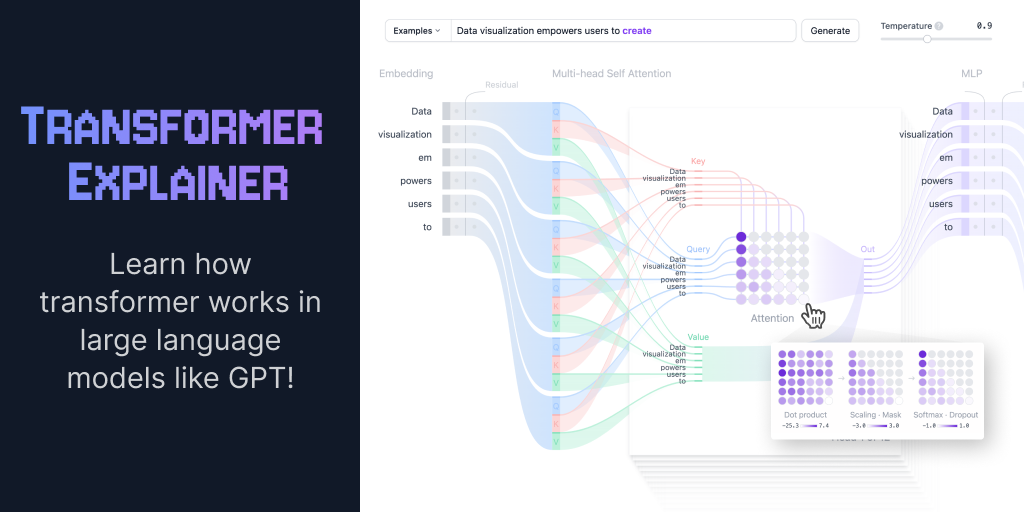
Cada modelo de Transformer generativo de texto está compuesto por tres componentes esenciales. Primero, se encuentra el embeding, donde la entrada de texto se divide en unidades más pequeñas, llamadas tokens, que luego se transforman en vectores numéricos que capturan el significado semántico de las palabras. Segundo, los bloques transformadores, que son la base del modelo, procesan los datos de entrada mediante un mecanismo de atención que permite que los tokens se comuniquen entre sí, identificando las relaciones contextuales. Por último, están las probabilidades de salida, donde las capas finales transforman los embeddings procesados en probabilidades, permitiendo al modelo hacer predicciones sobre el siguiente token en la secuencia.
El proceso de embedding en detalle
Cuando se desea generar texto con un modelo Transformer, como por ejemplo al utilizar el prompt «La visualización de datos empodera a los usuarios,» este texto debe ser convertido en un formato comprensible para el modelo mediante un proceso denominado embedding. La tokenización es el primer paso, donde el texto se segmenta en tokens. Estos tokens, una vez transformados en vectores numéricos, permiten al modelo entender el texto en un alto nivel semántico.
Posteriormente, se aplica la codificación posicional, que integra información sobre la disposición de los tokens en la secuencia de entrada, permitiendo que el modelo mantenga el contexto a medida que genera contenido.
Modelo de atención y capas MLP
El núcleo del procesamiento del Transformer radica en el bloque de Transformer, que incluye mecanismos de atención multi-cabeza y capas de perceptrón multicapa (MLP). En modelos como GPT-2, estas capas permiten que las representaciones de los tokens evolucionen a través de múltiples bloques, generando una comprensión más profunda de cada token. Cada cabeza de atención capta diferentes relaciones entre los tokens, lo que permite la paralelización en el aprendizaje de diversas características lingüísticas.
La capa MLP, que se aplica después de la atención, toma las salidas concatenadas de las múltiples cabezas y las proyecta a un espacio de dimensiones superiores. Esto permite que el modelo capture patrones más complejos que pueden no ser evidentes en la dimensión original. La combinación de estas técnicas incrementa significativamente la capacidad del modelo para aprender y generalizar.
Generación de texto y ajuste de parámetros
Una vez que el texto ha sido procesado a través de todos los bloques del Transformer, se prepara para la predicción del siguiente token. En este punto, se aplican funciones matemáticas que traducen las salidas en probabilidades, permitiendo seleccionar el siguiente token basado en su probabilidad de ser el adecuado en el contexto dado. Factores como la temperatura y los métodos de muestreo como top-k y top-p permiten ajustar la aleatoriedad y la creatividad del texto generado, brindando control sobre el estilo y la claridad del contenido producido.
Además de los componentes estructurales mencionados, elementos auxiliares como la normalización de capas, el dropout y las conexiones residuales son cruciales para el rendimiento del modelo, especialmente en fase de entrenamiento. Estos componentes ayudan a estabilizar el proceso de aprendizaje y a mitigar problemas comunes en redes neuronales profundas, asegurando que los modelos sean robustos y eficaces.
Con el auge de la inteligencia artificial, el potencial de los modelos Transformer sigue expandiéndose, ofreciendo nuevas oportunidades para la innovación en una variedad de campos, desde la generación automática de texto hasta aplicaciones de visión por computadora y más allá.